Python 3 爬取城市历史PM2.5数据
写在前面
基于python版本3,使用BeautifulSoup和requests库。 因为近来雾霾越来越严重,影响到的人群也是越来越多,一直想做一个PM2.5的统计,正好最近开始学习Python所有就拿它来练手了,新手不足之处还请指教。
正题
对比了几个可以查历史数据的网站后,选取的网站是www.aqistudy.cn,此网站的数据易于Python抓取且来源于环保部官方数据,从最早2013年12月到现在的记录,历史数据页面如下图。
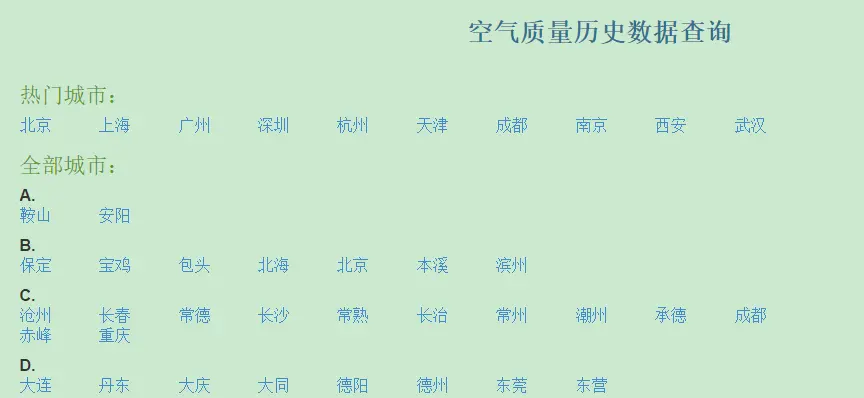
这次是爬取热门城市里的十个城市的历史数据并保持为CSV格式,分析页面源码可以看到模式如下。
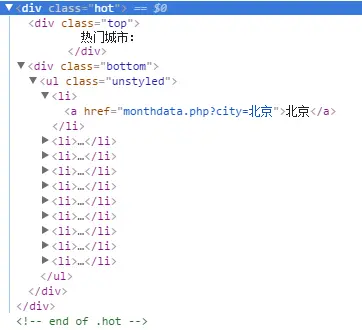 从这个大的
<div class="hot">标签里循环每一个 <li> 标签即可以得到每个城市名以及城市的Url。
### 获取城市名及城市的 URL
def getcity():
    hotcitys = rq.get(Url,headers=headers)
    soup = BeautifulSoup(hotcitys.text, 'lxml')  #这里使用lxml来解析
    citynames = []
    cityurls = []
    citys = soup.find_all('a',limit=19)[-10:]     #分片的形式来获取十个热门城市
    for city in citys:
        cityurl = city.get('href')
        cityurls.append(cityurl)
        cityname = city.get_text()
        citynames.append(cityname)
    return cityurls,citynames
cityurls,citynames = getcity()
导入 python 库
首先导入用到的几个库:
import requests as rq
import re
import io
from bs4 import BeautifulSoup起始网址:Url='https://www.aqistudy.cn/historydata/
为了防止网站针对爬虫的限制,把爬虫伪装成浏览器:
headers = { 'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36' }
抓取网址
再从抓取到的城市月数据网址开始抓取每月数据的网址:
def getwebs(url):
    data = rq.get(url,headers=headers).text
    soup = BeautifulSoup(data, 'lxml')
    ahrefs = soup.find_all('a')          #找到所有的链接
    webs = []
    names = []

    for href in ahrefs:
        href = href.get('href')
        hrefd = re.findall('(.*?month=\d{6})',href)  #用正则来匹配每月
        if hrefd:
            urls = Url + hrefd[0]
            webs.append(urls)

    return webs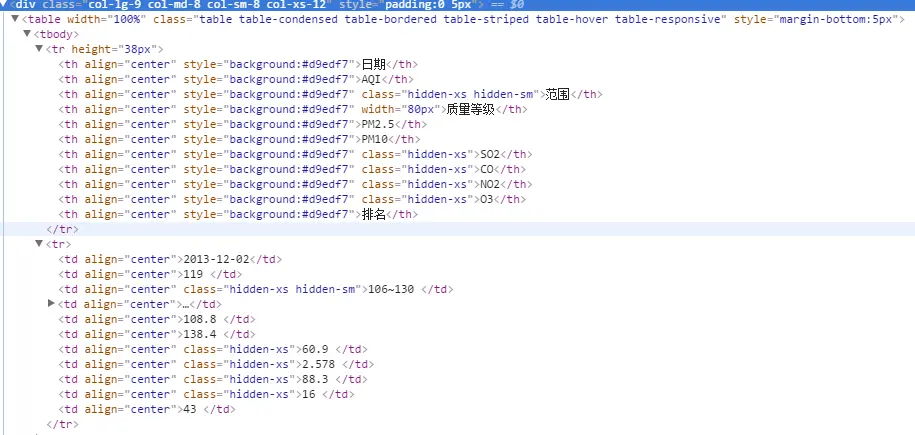
获得 天气数据
最后把每个城市对应的详细数据写入到CSV文件保存即完成。
def Savepm25(webs,path):
    for web in webs:
        print('正在下载数据...'+web)
        data = rq.get(web,headers=headers).text
        soup = BeautifulSoup(data, 'lxml')
        pms = soup.find_all('td')
        aqis = []
        for pm in pms:
            data = pm.get_text()
            aqis.append(data)
        i = 0
        while i < 12:
            aqis.pop()
            i = i + 1
        with open(path+'.csv', 'a+') as f:
             i = 1
             for aqi in aqis:
                if i % 11 != 0:
                    f.write(aqi + ',')       # CSV表格里以','为分隔符
                else:
                    f.write(aqi + '\r\n')    #若是行尾则换行
i = i + 1这里with open(path+'.csv', 'a+') as f:,'a+'是以追加的方式添加数据到CSV文件。
保存为 CSV
最后写一个循环来分别以 城市名.CSV 来保存到本地。
paths = []
for cityname in citynames:
    path = cityname + 'pm25'
    paths.append(path)
i = 0
for url in  cityurls:
    url = Url+url
    print(url)
    webs=getwebs(url)
    path = paths[i]
    Savepm25(webs,path)
    i = i + 1
写在最后
提示
本人刚开始学Python,很多地方没有考虑周到,只实现了基本功能、代码也不够健壮,还请高手可以多指点!或许您的一句话可以让我等新手少走些许弯路!